一份沿着真实疑问展开的学习复盘。重点不是背算法缩写,而是能回答:数据从哪里来,网络输入输出是什么,loss 为什么这样写,梯度更新谁,部署时究竟调用什么。 整理日期:2026 年 9 月 16 日。本文以经典算法的主要形式为准;不同论文版本和工程实现可能有所调整。数值例子用于解释机制,不代表实验结果
扩散语言模型每一步既要决定填什么 token,也要决定先填哪些位置。常见的置信度、概率差值、低熵策略,都根据当前预测选择位置。但当前容易预测,不代表填入后有利于后续生成;早期错误一旦固定,还可能继续传播。 LookUM 的核心是:提出几种填法,试填后重新预测,选择让后续状态更确定的分支。 技术方案:
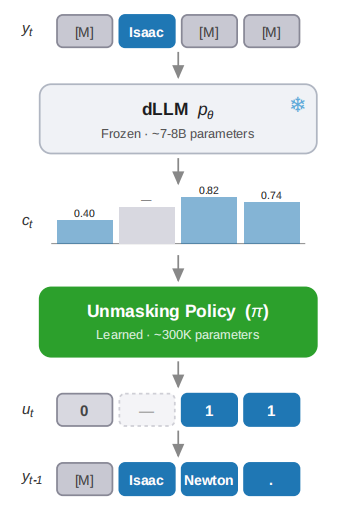
论文总结:Learning Unmasking Policies for Diffusion Language Models 核心思想: 不再人工规定扩散模型的生成顺序,而是通过强化学习自动决定每一步解除哪些 Mask。 具体方法: 建模: 将解掩码过程定义为 MDP,冻结原始扩散模型。 策略: 使
巴巴博弈队 · 计图挑战赛赛道一项目复盘 A 榜:1.534806,第 5 名;B 榜:1.3829,第 8 名 写在前面 如果只看最终方案,这个项目似乎可以被概括成一句话:提取时序图特征,训练 LightGBM 和 Jittor 排序模型,再把两者融合。 但这句话恰好省略了最重要的部分。 我们真正
